Modelagem lógica em bancos de dados relacionais
A modelagem lógica de banco de dados é uma etapa do projeto de bancos de dados responsável por transformar a representação conceitual das informações em estruturas organizadas de acordo com um modelo de dados, como o modelo relacional. Seu principal objetivo é definir como os dados serão estruturados, identificados e relacionados, preservando as regras de negócio identificadas anteriormente.
Durante o desenvolvimento de um sistema de informação, não basta compreender quais informações precisam ser armazenadas. Também é necessário determinar como essas informações serão organizadas para garantir consistência, integridade e facilidade de manutenção. Nesse contexto, a modelagem lógica estabelece uma ligação entre a compreensão do domínio do problema e a futura implementação do banco de dados.
Segundo Date (2004), o modelo relacional oferece uma fundamentação formal para representar dados por meio de relações, atributos e restrições de integridade. Essa abordagem permite estruturar as informações de maneira independente dos detalhes específicos de armazenamento utilizados por um Sistema Gerenciador de Banco de Dados (SGBD).
A modelagem lógica sucede a modelagem conceitual, frequentemente representada pelo Diagrama Entidade-Relacionamento (DER). Enquanto o modelo conceitual descreve entidades, atributos e relacionamentos existentes no domínio do problema, o modelo lógico traduz esses elementos em tabelas, colunas, chaves e restrições.
Se você ainda não estudou essa primeira etapa, recomendo a leitura do artigo Modelagem Conceitual de Banco de Dados, que apresenta os fundamentos do modelo Entidade-Relacionamento.
Neste artigo, estudaremos os elementos que compõem o Modelo Lógico de Dados (MLD), os diferentes tipos de chaves e, principalmente, as regras utilizadas para converter relacionamentos com cardinalidades 1:1, 1:N e N:N. Para facilitar a compreensão, utilizaremos exemplos relacionados a um sistema acadêmico de gerenciamento de alunos, professores, departamentos e disciplinas.
O que é o Modelo Lógico de Dados (MLD)?
O Modelo Lógico de Dados (MLD) é uma representação estruturada dos dados de um sistema, construída segundo as regras de um determinado modelo de organização de dados. No contexto dos bancos de dados relacionais, essa representação descreve as tabelas, seus atributos, os identificadores dos registros e os relacionamentos entre as estruturas.
Diferentemente da modelagem conceitual, que procura representar a realidade independentemente da tecnologia, a modelagem lógica considera as características do modelo de dados escolhido. Entretanto, ainda não precisa estabelecer detalhes físicos, como índices de desempenho, particionamento ou organização dos arquivos em disco.
De acordo com Date (2004), as relações constituem elementos fundamentais do modelo relacional, sendo organizadas a partir de atributos e submetidas a restrições que determinam quais valores são considerados válidos.
Em termos didáticos, a transformação de um modelo conceitual em um modelo lógico costuma envolver três operações fundamentais: converter entidades em tabelas, transformar atributos em colunas e representar os relacionamentos utilizando chaves ou tabelas adicionais.
Considere que um sistema acadêmico precisa armazenar informações sobre seus alunos. Na modelagem conceitual, poderíamos identificar a entidade Aluno, com os atributos matrícula, nome e e-mail.
Ao converter essa entidade para o modelo lógico, obtemos uma tabela relacional chamada ALUNO:
| matricula | Chave primária (PK) |
| nome | Atributo |
| Atributo |
Na representação acima, ALUNO é o nome da tabela, enquanto matricula, nome e email são suas colunas. A coluna matricula foi definida como chave primária, pois identifica individualmente cada aluno.
Em uma implementação real, a tabela poderia conter registros como os seguintes:
| matricula | nome | |
|---|---|---|
| 1001 | Ana Souza | ana@exemplo.com |
| 1002 | Bruno Lima | bruno@exemplo.com |
| 1003 | Carla Mendes | carla@exemplo.com |
Cada linha representa um aluno e cada coluna corresponde a uma característica armazenada. Entretanto, é importante distinguir a representação tabular utilizada nos SGBDs do conceito matemático de relação: no modelo relacional formal, uma relação é um conjunto de tuplas, sem ordenação intrínseca de linhas ou atributos (Date, 2004).
Diferenças entre modelagem conceitual, lógica e física
As três etapas desempenham papéis complementares no projeto de um banco de dados.
| Etapa | Principal preocupação | Elementos |
|---|---|---|
| Conceitual | O que precisa ser representado? | Entidades, atributos, relacionamentos e cardinalidades |
| Lógica | Como organizar os dados no modelo relacional? | Tabelas, colunas, chaves e restrições |
| Física | Como implementar e otimizar o armazenamento? | Tipos específicos, índices, estruturas físicas e configurações do SGBD |
Essa separação é importante porque possibilita discutir as regras de negócio antes de tomar decisões tecnológicas. Um mesmo modelo lógico relacional pode servir como ponto de partida para implementações em PostgreSQL, MySQL ou outros SGBDs relacionais, ainda que sejam necessários ajustes específicos em cada plataforma.
Chaves no modelo lógico de banco de dados
As chaves são atributos ou conjuntos de atributos utilizados para identificar registros e estabelecer associações entre tabelas. Elas são essenciais para garantir a integridade das informações e evitar ambiguidades durante a recuperação e a manipulação dos dados.
Na teoria relacional, o conceito de chave está relacionado à identificação única das tuplas de uma relação. Date (2004) destaca que as chaves candidatas são fundamentais para a identificação das informações, enquanto a escolha de uma chave primária possui especial importância na representação e na implementação dos esquemas relacionais.
Na modelagem lógica, estudaremos três categorias principais: chave primária, chave estrangeira e chave alternativa.
Chave primária (Primary Key — PK)
Uma chave primária é uma coluna ou combinação de colunas cujos valores identificam exclusivamente cada registro de uma tabela. Isso significa que dois registros distintos não podem possuir a mesma chave primária.
Uma chave primária apresenta duas propriedades essenciais: unicidade e ausência de valores nulos. Além disso, deve ser mínima, isto é, nenhum de seus atributos pode ser retirado sem comprometer a capacidade de identificar exclusivamente os registros.
Considere a tabela ALUNO. Se utilizarmos a matrícula como identificador, cada estudante deverá possuir um número diferente. Mesmo que dois alunos tenham o mesmo nome, a matrícula permitirá distingui-los sem ambiguidades.
A chave primária pode ser simples, quando formada por uma única coluna, ou composta, quando envolve duas ou mais colunas. Por exemplo, imagine uma tabela MATRICULA_DISCIPLINA que registra a participação dos alunos nas disciplinas acadêmicas.
| matricula_aluno | codigo_disciplina | semestre |
|---|---|---|
| 1001 | BD101 | 2026.1 |
| 1001 | PW201 | 2026.1 |
| 1002 | BD101 | 2026.1 |
Supondo que o sistema permita cursar novamente a mesma disciplina em semestres diferentes, poderíamos utilizar a combinação matricula_aluno, codigo_disciplina e semestre como chave primária composta.
Essa escolha permitiria que o mesmo aluno cursasse determinada disciplina em períodos distintos, mas impediria o cadastramento duplicado da mesma matrícula acadêmica no mesmo semestre.
A exigência de minimalidade merece atenção. Se a matrícula do aluno, isoladamente, já identificasse cada registro de determinada tabela, acrescentar o nome do aluno à chave não seria necessário e produziria uma combinação redundante.
Chave estrangeira (Foreign Key — FK)
Uma chave estrangeira é uma coluna ou conjunto de colunas utilizado para estabelecer uma referência entre registros, garantindo que determinados valores correspondam a identificadores válidos de outra tabela ou, eventualmente, da própria tabela. Sua função principal é preservar a integridade referencial.
No sistema acadêmico, imagine que cada aluno esteja vinculado a um curso. Teríamos duas tabelas: CURSO, responsável pelos cursos oferecidos pela instituição, e ALUNO, responsável pelas informações dos estudantes (Figura 1).
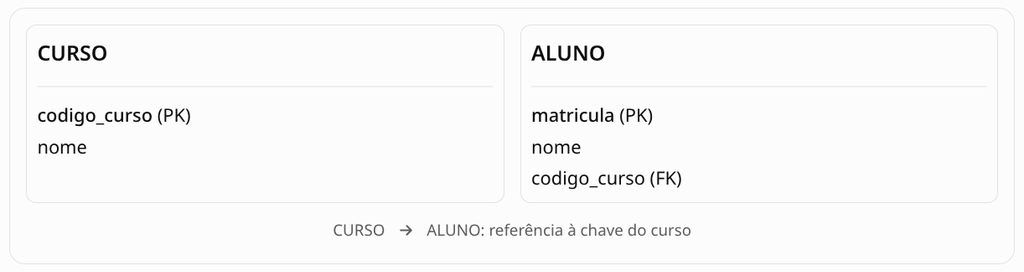
Figura 1 – Tabelas Curso e Aluno. Elaborado pelo autor.
Nesse caso, codigo_curso é a chave primária de CURSO e aparece como chave estrangeira na tabela ALUNO.
Se um estudante estiver vinculado ao curso de código 10, esse curso deverá existir na tabela CURSO. Caso contrário, haverá uma referência inválida.
A integridade referencial é uma das propriedades centrais dos bancos de dados relacionais. Conforme a documentação oficial do PostgreSQL (2026), a restrição de chave estrangeira assegura que valores referenciados correspondam a registros válidos, respeitando também as regras definidas para valores nulos.
É importante destacar que uma chave estrangeira não precisa obrigatoriamente referenciar uma chave primária. Dependendo do SGBD e das restrições declaradas, ela também pode referenciar outra chave que possua garantia de unicidade.
Além disso, uma chave estrangeira pode referenciar a própria tabela. Imagine um cadastro de professores no qual cada professor pode possuir outro professor como supervisor acadêmico. Nesse caso, a coluna codigo_supervisor poderia referenciar a chave primária codigo_professor da própria tabela PROFESSOR.
Chave alternativa (Alternate Key — AK)
Uma chave alternativa é uma chave candidata que possui capacidade de identificar exclusivamente os registros, mas que não foi escolhida como chave primária.
Para compreender esse conceito, precisamos diferenciar chave candidata e chave primária. Uma chave candidata é qualquer conjunto mínimo de atributos capaz de identificar unicamente os registros. Entre as chaves candidatas existentes, uma é escolhida como chave primária, e as demais recebem a classificação de chaves alternativas.
Considere a tabela PROFESSOR, contendo os atributos codigo_professor, cpf e nome. Supondo que tanto codigo_professor quanto cpf sejam únicos, não nulos e capazes de identificar individualmente os professores, ambos são chaves candidatas. Entretanto, se codigo_professor for escolhido como chave primária, cpf passará a ser uma chave alternativa (Figura 2).
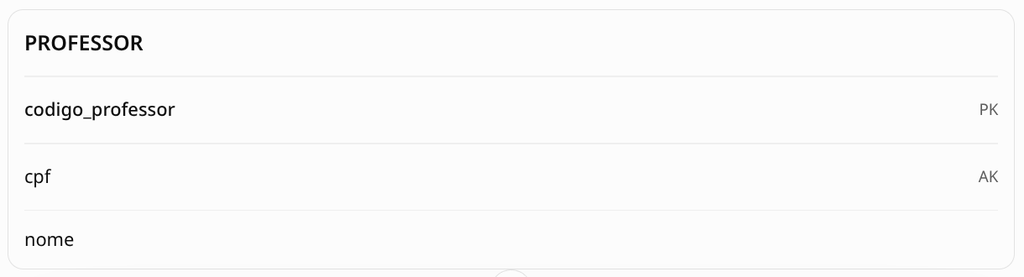
Figura 2 – Tabela Professor com seus respectivos campos. Elaborado pelo autor.
Na implementação SQL, essa chave alternativa pode ser protegida por uma restrição UNIQUE associada à proibição de valores nulos, caso a regra de negócio exija a presença obrigatória do CPF.
Essa distinção é relevante porque a escolha da chave primária não elimina a necessidade de preservar a unicidade das demais chaves candidatas (Date, 2004).
Conversão do modelo conceitual para o modelo lógico
A conversão do modelo conceitual para o modelo lógico é o processo pelo qual os elementos identificados no Diagrama Entidade-Relacionamento são traduzidos para estruturas compatíveis com o modelo relacional.
No procedimento convencional, cada entidade regular origina uma tabela, seus atributos simples tornam-se colunas e seus atributos identificadores são utilizados para definir chaves candidatas, das quais uma será selecionada como chave primária.
Entretanto, a conversão não se resume a transformar entidades em tabelas. É necessário determinar como representar os relacionamentos, pois o modelo relacional utiliza valores de atributos e restrições de integridade para associar informações.
As três estratégias fundamentais abordadas neste artigo são a criação de uma tabela própria, a adição de colunas em uma tabela existente e a fusão de tabelas.
A escolha depende principalmente da cardinalidade máxima e mínima dos relacionamentos, mas também considera as regras de negócio, a independência das entidades e as restrições de integridade exigidas pelo sistema.
Cardinalidade máxima e mínima
A cardinalidade indica quantas ocorrências de uma entidade podem ou devem estar associadas a ocorrências de outra entidade.
A cardinalidade máxima determina o número máximo de associações permitidas. Por sua vez, a cardinalidade mínima indica a quantidade mínima de associações exigidas.
Na notação utilizada no modelo conceitual, podemos encontrar combinações como (0,1), (1,1), (0,N) e (1,N).
| Cardinalidade | Interpretação |
|---|---|
| (0,1) | Participação opcional, com no máximo uma associação |
| (1,1) | Participação obrigatória, com exatamente uma associação |
| (0,N) | Participação opcional, permitindo várias associações |
| (1,N) | Participação obrigatória, permitindo várias associações |
Por exemplo, se cada aluno deve pertencer a exatamente um curso, sua participação no relacionamento com CURSO será (1,1). Por outro lado, se um curso pode possuir vários alunos, mas também pode existir antes da primeira matrícula, sua participação será (0,N).
Nesse cenário, temos um relacionamento do tipo 1:N, cuja representação lógica será estudada nas próximas seções.
Conversão de relacionamentos 1:1 (um para um)
Um relacionamento 1:1 ocorre quando uma ocorrência de determinada entidade pode estar associada a, no máximo, uma ocorrência de outra entidade, e vice-versa.
Esse tipo de relacionamento é comum quando duas entidades representam informações distintas, mas possuem uma associação individualizada. Por exemplo, um professor pode ser responsável por um único departamento e cada departamento pode possuir apenas um professor responsável.
Na conversão para o modelo lógico, existem três estratégias possíveis: adicionar uma chave estrangeira a uma das tabelas, criar uma tabela específica para o relacionamento ou fundir as entidades em uma única tabela.
A decisão depende principalmente das cardinalidades mínimas, que determinam se a associação é obrigatória ou opcional.
Relacionamento (0,1) – (0,1)
Considere duas entidades: PROFESSOR e GABINETE. Imagine que cada professor pode possuir um gabinete individual, mas alguns professores ainda não receberam um. Da mesma forma, alguns gabinetes podem estar desocupados. Nesse cenário, ambos os lados possuem cardinalidade (0,1).
Na Figura 3 apresentamos uma proposta de solução consiste em adicionar uma chave estrangeira à tabela PROFESSOR, indicando qual gabinete está atribuído a cada professor.
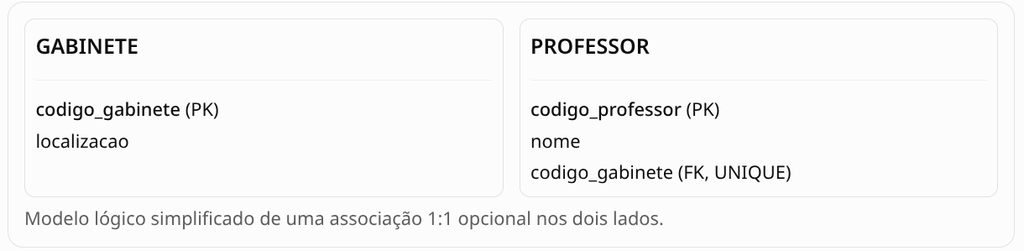
Figura 3 – Tabelas Gabinete e Professor. Elaborado pelo autor.
A coluna codigo_gabinete da tabela PROFESSOR representa a chave estrangeira. Como nem todos os professores possuem gabinete, ela poderá receber um valor nulo.
Entretanto, há uma condição importante: a chave estrangeira também precisa possuir uma restrição de unicidade. Sem essa restrição, diferentes professores poderiam apontar para o mesmo gabinete, transformando o relacionamento em 1:N.
Uma alternativa igualmente válida seria armazenar codigo_professor na tabela GABINETE. A escolha dependeria das regras de negócio e da conveniência de manutenção do modelo.
Outra possibilidade seria criar uma terceira tabela, chamada ATRIBUICAO_GABINETE, contendo as chaves de professor e gabinete. Essa estrutura pode ser interessante quando a associação possui atributos próprios, como a data de atribuição.
A fusão das tabelas, por outro lado, geralmente não é adequada nesse cenário, pois obrigaria a tratar conjuntamente entidades que podem existir de maneira independente.
Relacionamento (0,1) – (1,1)
Agora considere a relação entre PROFESSOR e CREDENCIAL_ACESSO. Suponha que um professor possa não possuir credencial digital, mas que toda credencial cadastrada obrigatoriamente pertença a um único professor. Além disso, um professor pode possuir, no máximo, uma credencial. Temos, portanto, participação opcional de PROFESSOR e obrigatória de CREDENCIAL_ACESSO, conforme a Figura 4.
Nesse caso, a solução mais simples é adicionar a chave estrangeira na tabela cuja participação é obrigatória.
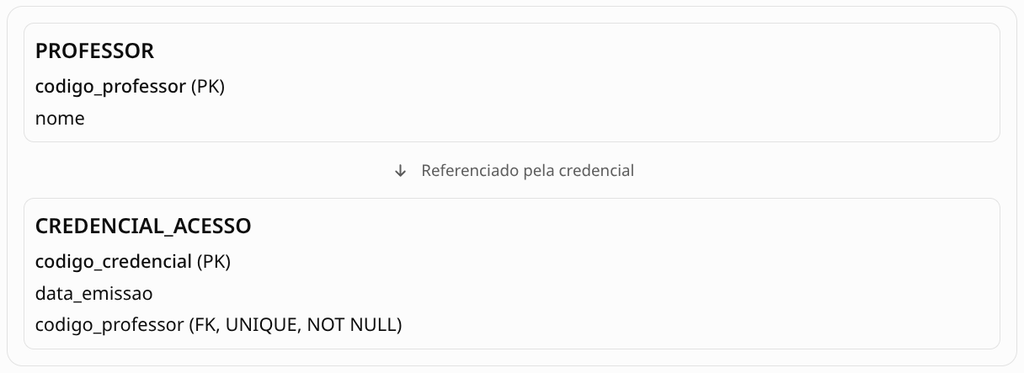
Figura 4 – Tabelas Professor e Credencial_Acesso. Elaborado pelo autor.
A chave estrangeira codigo_professor deverá ser obrigatória (NOT NULL), porque não pode existir uma credencial sem professor. Também será única (UNIQUE), porque cada professor poderá possuir apenas uma credencial.
Essa estratégia preserva as cardinalidades máximas e permite que professores existam sem credenciais.
Observe que inverter a chave estrangeira exigiria cuidados adicionais. Se armazenássemos codigo_credencial em PROFESSOR, seria possível impedir que dois professores utilizassem a mesma credencial, mas uma simples chave estrangeira não garantiria que toda credencial estivesse associada a um professor.
Portanto, a escolha do lado que recebe a chave estrangeira não é apenas uma questão estética: ela influencia diretamente a capacidade de representar as regras de negócio.
Relacionamento (1,1) – (1,1)
Em um relacionamento (1,1) – (1,1), ambas as entidades devem participar obrigatoriamente da associação.
Considere uma situação hipotética em que cada departamento administrativo possui exatamente um centro de custos e cada centro de custos pertence a exatamente um departamento. Nesse caso, uma alternativa é realizar a fusão das tabelas, especialmente quando ambas as entidades compartilham o mesmo ciclo de vida e não precisam ser administradas separadamente.
A estrutura resultante poderia ser:
| DEPARTAMENTO_CUSTO |
|---|
| codigo_departamento (PK) |
| nome_departamento |
| codigo_centro_custo (UNIQUE, NOT NULL) |
| descricao_centro_custo |
A tabela reuniria os atributos originalmente associados às duas entidades. O identificador codigo_departamento poderia ser escolhido como chave primária, enquanto codigo_centro_custo permaneceria como chave alternativa, desde que a combinação de regras garantisse sua identificação única.
Entretanto, a fusão não é obrigatória. Se os departamentos e centros de custos possuírem responsabilidades administrativas distintas, pode ser mais apropriado preservar duas tabelas.
Nesse caso, é necessário observar que uma simples chave estrangeira UNIQUE NOT NULL garante a participação obrigatória do lado que a contém, mas não assegura, isoladamente, a participação obrigatória de todos os registros da tabela referenciada. Para garantir ambos os lados, podem ser necessárias restrições adicionais, procedimentos transacionais ou mecanismos específicos do SGBD.
Essa observação demonstra que a conversão de relacionamentos deve considerar não apenas a estrutura das tabelas, mas também a capacidade efetiva de garantir as regras de integridade (DATE, 2004).
Conversão de relacionamentos 1:N (um para muitos)
Um relacionamento 1:N ocorre quando uma ocorrência de determinada entidade pode estar associada a várias ocorrências de outra entidade, enquanto cada ocorrência desta última pode estar associada a, no máximo, uma ocorrência da primeira.
Esse é um dos relacionamentos mais comuns nos sistemas de informação. Podemos encontrá-lo em associações entre clientes e pedidos, departamentos e funcionários, cursos e alunos ou categorias e produtos.
A regra geral de conversão consiste em adicionar a chave primária da entidade do lado 1 como chave estrangeira na tabela correspondente ao lado N.
Essa estratégia permite que vários registros apontem para o mesmo elemento da tabela referenciada, sem necessidade de repetir suas demais informações.
Exemplo: curso e aluno
Considere uma instituição de ensino na qual cada aluno pertence a um único curso, mas um curso pode possuir diversos alunos. No modelo conceitual da Figura 5, temos duas entidades: CURSO e ALUNO, associadas por um relacionamento 1:N.
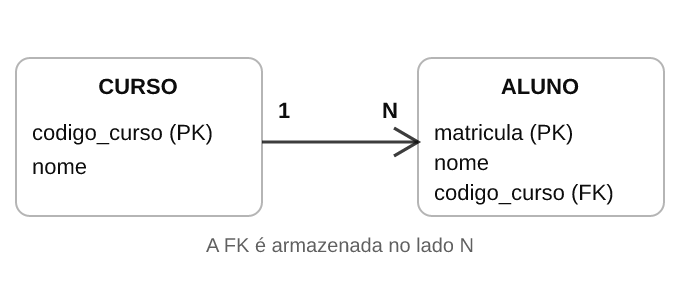
Figura 5 – Tabelas Curso e Aluno e o relacionamento 1:N entre elas. Elaborado pelo autor.
A tabela CURSO possui a chave primária codigo_curso, enquanto a tabela ALUNO contém a chave estrangeira codigo_curso.
Considere os seguintes dados:
Tabela CURSO
| codigo_curso | nome |
|---|---|
| 10 | Análise e Desenvolvimento de Sistemas |
| 20 | Administração |
Tabela ALUNO
| matricula | nome | codigo_curso |
|---|---|---|
| 1001 | Ana | 10 |
| 1002 | Bruno | 10 |
| 1003 | Carla | 20 |
Observe que os alunos Ana e Bruno possuem o mesmo valor de codigo_curso, indicando que ambos pertencem ao curso de Análise e Desenvolvimento de Sistemas.
Essa repetição da chave estrangeira é esperada e não representa uma redundância problemática. O atributo repetido corresponde apenas ao identificador do curso, enquanto suas informações descritivas permanecem armazenadas em uma única tabela.
Se o nome do curso for alterado, será necessário atualizar somente o registro correspondente na tabela CURSO.
Essa organização está relacionada aos princípios de projeto relacional e à redução de redundâncias, estudados com maior profundidade no artigo Normalização de Banco de Dados.
Como a cardinalidade mínima influencia a chave estrangeira?
Embora a conversão de relacionamentos 1:N geralmente utilize a adição de uma chave estrangeira, a cardinalidade mínima determina se essa coluna pode ou não receber valores nulos.
Se todo aluno for obrigado a pertencer a um curso, codigo_curso deverá ser definido como obrigatório (NOT NULL). Caso o sistema permita cadastrar alunos ainda não vinculados a um curso, a coluna poderá aceitar valores nulos. Contudo, existe uma distinção importante entre obrigatoriedade no lado N e obrigatoriedade no lado 1.
Imagine que todo curso deva possuir pelo menos um aluno. Essa regra não pode ser garantida apenas pela chave estrangeira existente em ALUNO. Afinal, seria possível cadastrar um curso sem cadastrar nenhum estudante. Para assegurar a existência de pelo menos um aluno por curso, precisaríamos de mecanismos adicionais de validação, considerando também as operações de inserção, exclusão e atualização dos registros.
Em outras palavras, a chave estrangeira representa adequadamente o limite máximo de um curso por aluno, mas nem todas as cardinalidades mínimas podem ser garantidas por uma única restrição referencial.
Por que não criar uma tabela própria?
A criação de uma terceira tabela também pode representar um relacionamento 1:N. Imagine uma estrutura formada por CURSO, ALUNO e VINCULO_CURSO, em que esta última armazena as chaves de ambas as tabelas.
Entretanto, essa decisão introduziria uma estrutura adicional e exigiria restrições que impedissem a vinculação simultânea de um aluno a vários cursos, caso essa fosse a regra de negócio. Por isso, quando o relacionamento não possui necessidades específicas de representação, a adição de uma chave estrangeira ao lado N costuma ser a solução mais simples.
Uma tabela própria pode fazer sentido quando a associação precisa ter identidade, histórico ou características próprias. Por exemplo, se a instituição deseja manter um registro histórico das transferências de alunos entre cursos, uma tabela de vínculos contendo datas de início e término pode ser apropriada. Nesse caso, porém, o modelo passa a representar os vínculos ao longo do tempo, e não apenas a associação atual.
Conversão de relacionamentos N:N (muitos para muitos)
Um relacionamento N:N ocorre quando uma ocorrência de determinada entidade pode estar associada a várias ocorrências de outra entidade, e vice-versa.
Esse tipo de associação aparece com frequência nos sistemas acadêmicos. Um aluno pode cursar várias disciplinas e uma disciplina pode possuir vários alunos matriculados.
Na modelagem conceitual, essa situação é representada diretamente por um relacionamento N:N. Entretanto, no modelo lógico relacional convencional, é necessário criar uma estrutura intermediária para representar cada associação entre os registros.
Essa estrutura é denominada tabela associativa, também conhecida como tabela de junção ou tabela intermediária.
Exemplo: aluno e disciplina
Considere as entidades ALUNO e DISCIPLINA. Cada aluno pode cursar diversas disciplinas durante sua formação. Da mesma forma, uma disciplina pode ser cursada por diversos estudantes.
Para representar essa associação, criaremos a tabela MATRICULA_DISCIPLINA, contendo as chaves estrangeiras das duas entidades. Assim, a tabela associativa transforma um relacionamento N:N em dois relacionamentos 1:N. Logo, a tabela MATRICULA_DISCIPLINA armazena uma ocorrência para cada vínculo acadêmico entre aluno e disciplina, conforme a Figura 6.
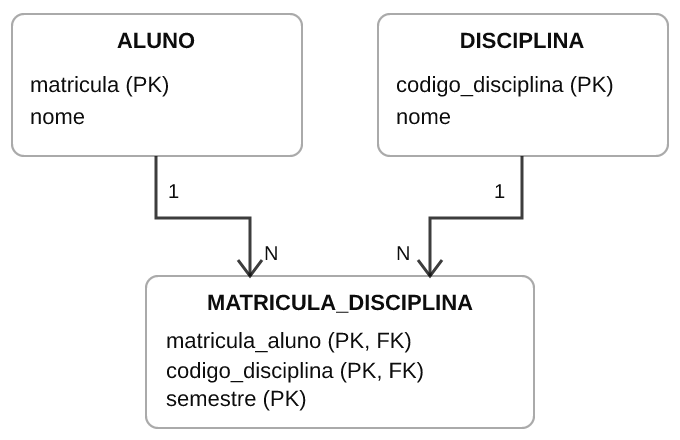
Figura 6 – Tabela associativa Matricula_Disciplina entre as tabelas Aluno e Disciplina. Elaborado pelo autor.
Em um exemplo simplificado, poderíamos utilizar os seguintes registros:
| matricula_aluno | codigo_disciplina | semestre |
|---|---|---|
| 1001 | BD101 | 2026.1 |
| 1001 | PW201 | 2026.1 |
| 1002 | BD101 | 2026.1 |
| 1001 | BD101 | 2026.2 |
O aluno de matrícula 1001 está associado a diferentes disciplinas. Ao mesmo tempo, a disciplina BD101 possui diferentes alunos.
Observe também que o aluno 1001 aparece duas vezes associado à disciplina BD101, mas em semestres distintos. Isso representa a possibilidade de cursar novamente a disciplina.
Como definir a chave primária da tabela associativa?
Na conversão tradicional de um relacionamento N:N, uma solução comum consiste em utilizar as chaves primárias das entidades participantes para formar a chave primária composta da tabela associativa.
Entretanto, essa regra precisa considerar o significado dos registros armazenados.
Se cada aluno pudesse cursar uma disciplina apenas uma vez, a combinação matricula_aluno e codigo_disciplina seria suficiente para identificar exclusivamente cada vínculo.
Por outro lado, como nosso sistema admite que um aluno curse a mesma disciplina em semestres diferentes, precisamos acrescentar semestre à chave composta ou utilizar outra estratégia de identificação que preserve a regra de unicidade desejada.
Dessa forma, o esquema lógico pode ser representado por:
ALUNO(
    matricula PK,
    nome,
    email
)

DISCIPLINA(
    codigo_disciplina PK,
    nome,
    carga_horaria
)

MATRICULA_DISCIPLINA(
    matricula_aluno PK, FK,
    codigo_disciplina PK, FK,
    semestre PK
)
É importante observar que as chaves estrangeiras da tabela associativa não precisam, obrigatoriamente, constituir toda a chave primária. Em alguns projetos, utiliza-se uma chave artificial própria, como codigo_matricula, acompanhada de uma restrição de unicidade sobre os atributos que identificam o vínculo.
Essa alternativa pode ser conveniente quando outras tabelas precisam fazer referência à matrícula acadêmica. Entretanto, a introdução de um identificador artificial não elimina a necessidade de garantir que os vínculos não sejam duplicados indevidamente.
Atributos próprios dos relacionamentos
Uma característica importante dos relacionamentos N:N é a possibilidade de possuírem atributos que descrevem a associação entre as entidades, e não cada entidade isoladamente.
Considere, por exemplo, a nota final obtida por um aluno em determinada disciplina.
A nota não pertence exclusivamente à entidade ALUNO, porque um mesmo estudante pode possuir notas diferentes em disciplinas distintas. Também não pertence exclusivamente à entidade DISCIPLINA, porque os estudantes matriculados podem obter resultados diferentes.
Portanto, a nota é uma característica do vínculo entre o aluno e a disciplina.
A tabela associativa pode ser ampliada:
MATRICULA_DISCIPLINA(
    matricula_aluno PK, FK,
    codigo_disciplina PK, FK,
    semestre PK,
    nota_final,
    frequencia,
    situacao
)
Agora, além de registrar a associação, essa tabela armazena informações referentes à participação acadêmica do aluno.
Essa decisão também contribui para evitar dependências inadequadas e redundâncias. Quando os atributos são armazenados nas tabelas correspondentes às entidades ou aos relacionamentos que efetivamente descrevem, o modelo tende a apresentar maior coerência.
Esse aspecto está diretamente relacionado aos princípios da normalização, especialmente à identificação de dependências funcionais e à organização dos atributos nas relações (DATE, 2004).
Comparação das estratégias de conversão
Após estudar os três tipos principais de relacionamento, podemos sintetizar as alternativas utilizadas na modelagem lógica:
| Relacionamento | Estratégia geralmente recomendada | Cuidados |
|---|---|---|
| 1:1, ambos opcionais | Chave estrangeira UNIQUE em um dos lados ou tabela própria | Preservar a opcionalidade das entidades |
| 1:1, um lado obrigatório | Chave estrangeira UNIQUE NOT NULL no lado obrigatório | Garantir unicidade e participação obrigatória |
| 1:1, ambos obrigatórios | Fusão, quando apropriada, ou tabelas separadas | Garantir a participação total nos dois lados |
| 1:N | Chave estrangeira no lado N | Respeitar a cardinalidade mínima |
| N:N | Tabela associativa | Definir corretamente PK, FKs e atributos do vínculo |
É importante compreender que essas estratégias são orientações de projeto, e não regras universais aplicáveis sem análise.
A cardinalidade estabelece restrições estruturais, mas o desenvolvedor também precisa considerar o ciclo de vida das entidades, a necessidade de manter históricos, a existência de atributos próprios nos relacionamentos e as possibilidades de imposição das restrições pelo SGBD. Assim, um projeto bem elaborado deve justificar suas escolhas com base nas regras de negócio e nos princípios do modelo relacional.
Integridade dos dados e validação do modelo lógico
Além de estabelecer tabelas e relacionamentos, a modelagem lógica precisa especificar quais condições devem ser respeitadas para que os registros permaneçam consistentes. Essas condições são denominadas restrições de integridade e representam regras que o banco de dados deve preservar durante as operações de inserção, atualização e exclusão.
Podemos distinguir três categorias fundamentais:
A integridade de entidade determina que cada registro seja identificável por uma chave primária, cujos valores não podem ser nulos. Essa propriedade impede que duas linhas compartilhem o mesmo identificador e permite que as aplicações recuperem e modifiquem registros específicos.
A integridade referencial estabelece que os relacionamentos entre tabelas devem utilizar referências válidas. Por exemplo, não deve ser possível cadastrar uma matrícula acadêmica vinculada a um aluno inexistente.
Por fim, a integridade de domínio estabelece restrições sobre os valores permitidos para determinados atributos. Uma nota acadêmica, por exemplo, pode estar limitada ao intervalo entre 0 e 100, enquanto a carga horária de uma disciplina deve possuir um valor positivo.
A documentação oficial do PostgreSQL (2026) apresenta mecanismos como PRIMARY KEY, FOREIGN KEY, UNIQUE, NOT NULL e CHECK para implementar diferentes restrições de integridade. Essas restrições precisam ser consideradas durante a modelagem lógica, mesmo que sua implementação detalhada seja realizada posteriormente, na etapa física.
A relação entre modelagem lógica e normalização
A construção do modelo lógico também deve considerar a organização adequada dos atributos para reduzir redundâncias e prevenir anomalias de atualização.
Considere uma tabela que armazene a matrícula do aluno, seu nome, o código da disciplina, o nome da disciplina e a nota obtida. Se vários estudantes cursarem a mesma disciplina, seu nome será repetido em diferentes registros. Uma alteração no nome da disciplina poderá exigir diversas atualizações, aumentando o risco de inconsistências. A normalização fornece princípios formais para investigar essas situações, considerando as dependências entre atributos e a decomposição de relações.
Segundo Date (2004), a teoria relacional e as formas normais oferecem fundamentos para analisar estruturas de dados e evitar determinadas redundâncias prejudiciais. Por isso, a modelagem lógica e a normalização são atividades complementares. Enquanto a conversão do modelo conceitual estabelece as estruturas e associações, a normalização permite avaliar se essas estruturas apresentam dependências inadequadas.
Para aprofundar esse assunto, consulte o artigo Normalização de banco de dados relacionais: da 1FN à 3FN.
Exemplo integrado: construindo um modelo lógico acadêmico
Para consolidar os conceitos estudados, considere um sistema acadêmico composto pelas entidades CURSO, ALUNO, PROFESSOR, GABINETE, DISCIPLINA e MATRICULA_DISCIPLINA.
O sistema precisa respeitar as seguintes regras de negócio: cada aluno pertence a um curso; um curso pode possuir vários alunos; cada professor pode receber um gabinete individual; um gabinete pode permanecer desocupado; um aluno pode cursar várias disciplinas; e cada disciplina pode possuir vários alunos.
A partir dessas informações, identificamos três relacionamentos distintos.
- O relacionamento entre
CURSOeALUNOé do tipo 1:N. Consequentemente, a chave primária deCURSOserá incorporada à tabelaALUNOcomo chave estrangeira. - O relacionamento entre
PROFESSOReGABINETEé do tipo 1:1, com participação opcional em ambos os lados. Nesse caso, podemos adicionar a chave estrangeira de gabinete à tabela de professores, acompanhada de uma restrição de unicidade. - Finalmente, o relacionamento entre
ALUNOeDISCIPLINAé do tipo N:N. Portanto, será necessário criar a tabela associativaMATRICULA_DISCIPLINA.
O modelo lógico resultante pode ser representado textualmente:
CURSO(
    codigo_curso PK,
    nome
)

ALUNO(
    matricula PK,
    nome,
    email,
    codigo_curso FK
)

PROFESSOR(
    codigo_professor PK,
    nome,
    cpf AK,
    codigo_gabinete FK, UNIQUE
)

GABINETE(
    codigo_gabinete PK,
    localizacao
)

DISCIPLINA(
    codigo_disciplina PK,
    nome,
    carga_horaria
)

MATRICULA_DISCIPLINA(
    matricula_aluno PK, FK,
    codigo_disciplina PK, FK,
    semestre PK,
    nota_final,
    frequencia,
    situacao
)
Observe que a notação apresentada não corresponde a comandos SQL executáveis. Trata-se de uma representação textual simplificada do esquema lógico, na qual identificamos as tabelas, os atributos e suas restrições principais.
A implementação real exigirá a definição dos tipos de dados, das restrições obrigatórias e dos comandos de criação das tabelas. Essa atividade pertence à próxima etapa do projeto: a modelagem física.
Conclusão
A modelagem lógica de banco de dados constitui uma etapa fundamental para transformar as informações identificadas durante a modelagem conceitual em estruturas compatíveis com o modelo relacional.
Seu domínio exige compreender não apenas a conversão de entidades em tabelas, mas principalmente o papel das chaves e das cardinalidades na representação das associações.
Os relacionamentos 1:1 exigem atenção à obrigatoriedade e à unicidade dos vínculos. Nos relacionamentos 1:N, a estratégia mais comum consiste em adicionar uma chave estrangeira ao lado N. Já os relacionamentos N:N são representados por tabelas associativas, que permitem armazenar os vínculos e seus atributos específicos.
Entretanto, uma modelagem correta não depende exclusivamente da aplicação mecânica dessas regras. É necessário verificar se as estruturas propostas preservam as regras de negócio, evitam redundâncias desnecessárias e permitem a imposição adequada das restrições de integridade.
Para o profissional de desenvolvimento de software, compreender essas decisões facilita a construção de sistemas consistentes, a implementação de consultas SQL e a manutenção dos bancos de dados ao longo do ciclo de vida das aplicações.
Obrigado pela leitura e bons estudos!
Referências
DATE, C. J. Introdução a sistemas de bancos de dados. 8. ed. Rio de Janeiro: Elsevier, 2004.
POSTGRESQL GLOBAL DEVELOPMENT GROUP. PostgreSQL 18 documentation: 5.5. Constraints. 2026. Disponível em: https://www.postgresql.org/docs/18/ddl-constraints.html. Acesso em: 31 out. 2026.