Concorrência em Sistemas Operacionais
Desde a década de 1970, os computadores começaram a permitir que os desenvolvedores e usuários executassem diversos programas de forma simultânea. Essa capacidade gerou a crença popular de que “tudo é executado ao mesmo tempo”, como se todas as centenas de programas pudessem ser acessadas e processadas literalmente ao mesmo tempo.
Apesar de existirem diversos núcleos nos atuais chips de CPU (dual-core, quad-core, octa-core etc.), ainda é não possível que centenas de tarefas sejam literalmente processadas na CPU ao mesmo tempo. Essa ilusão, contudo, originou-se da possibilidade de competição entre os programas pelos recursos do hardware. Essa disputa é conhecida como concorrência.
O que é a concorrência em sistemas operacionais?
O conceito de concorrência pode ser compreendido com a execução simultânea de tarefas em um ambiente de computação. De acordo com Machado e Maia (2014), a concorrência em computadores é o princípio básico para o projeto e a implementação de sistemas multiprogramáveis.
A concorrência é viabilizada pela capacidade do processador de executar instruções ao mesmo tempo em que outras operações, como as de Entrada/Saída (E/S), estão em andamento no sistema computacional.
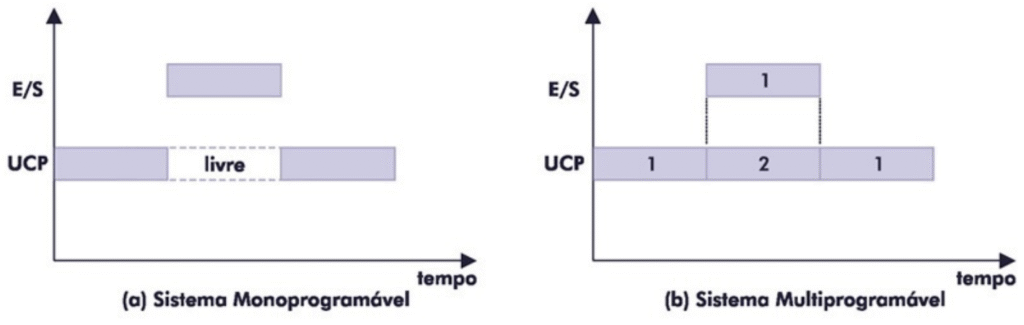
Nos antigos sistemas monoprogramáveis, os recursos computacionais (processador, memória e E/S) eram utilizados de forma pouco eficiente. O processador permanecia dedicado exclusivamente a uma única tarefa. Quando essa tarefa realizava uma operação de E/S – como uma leitura em disco, por exemplo -, o processador ficava ocioso, resultando em subutilização da capacidade de processamento por longos períodos.
A multiprogramação superou essa limitação ao permitir que vários programas estivessem residentes na memória simultaneamente. Dessa forma, quando um programa solicitava uma operação de E/S e passava para o estado de espera, outros programas podiam utilizar o processador. Isso permite que a Unidade Central de Processamento (UCP) permaneça menos tempo ociosa e que a memória principal seja usada de forma mais eficiente. Surge então a concorrência em sistemas operacionais, pois agora os recursos de CPU, memória e dispositivos de E/S são disputados pelos programas que desejam utilizá-los.
Para exemplificar o principal benefício dos sistemas multiprogramáveis, a Figura 1 mostra dois gráficos bidimensionais que demonstram o que acontece em sistemas monoprogramáveis e multiprogramáveis no cenário onde se deseja executar dois programas.
Fonte: Machado e Maia (2014, p. 61).
Para gerenciar essa disputa pelos recursos, o sistema utiliza mecanismos que desviam o fluxo normal de execução do programa na CPU. Estes mecanismos são as interrupções e as exceções.
Mecanismos de controle do fluxo: Interrupções e Exceções
Esses mecanismos são implementados como sinais elétricos ou instruções de código que avisam o núcleo de processamento sobre a necessidade de mudança no fluxo normal de execução e a troca de tarefas.
As interrupções são eventos inesperados, geralmente causados por sinais de dispositivos de hardware externos ao processador. Ao final da execução de cada instrução, a Unidade de Controle verifica a ocorrência de alguma interrupção. Se houver, o programa é interrompido, e o controle é desviado para uma rotina de tratamento de interrupção. É essencial que, nesse momento, o sistema preserve o conteúdo de registradores (como o Program Counter – PC, e o Registrador de Status), para que o programa possa ser restaurado e continuar seu processamento posteriormente.
Por outro lado, as exceções são eventos previsíveis que ocorrem em função da execução de instruções do próprio programa (também chamados de eventos síncronos). Pode-se citar como exemplos de exceções os erros em operações aritméticas, como divisão por zero, ou as falhas de página (page fault) em memória virtual. O mecanismo de tratamento de exceções pode, frequentemente, ser escrito pelo programador para evitar o encerramento inesperado do programa pelo próprio sistema operacional.
A Figura 2 apresenta a operação do sistema operacional no caso onde ocorre uma interrupção ou uma exceção. Essa mudança de fluxo obriga o sistema a realizar uma troca de contexto para executar uma rotina de tratamento específica para a interrupção acionada pelo hardware ou pelo próprio programa.
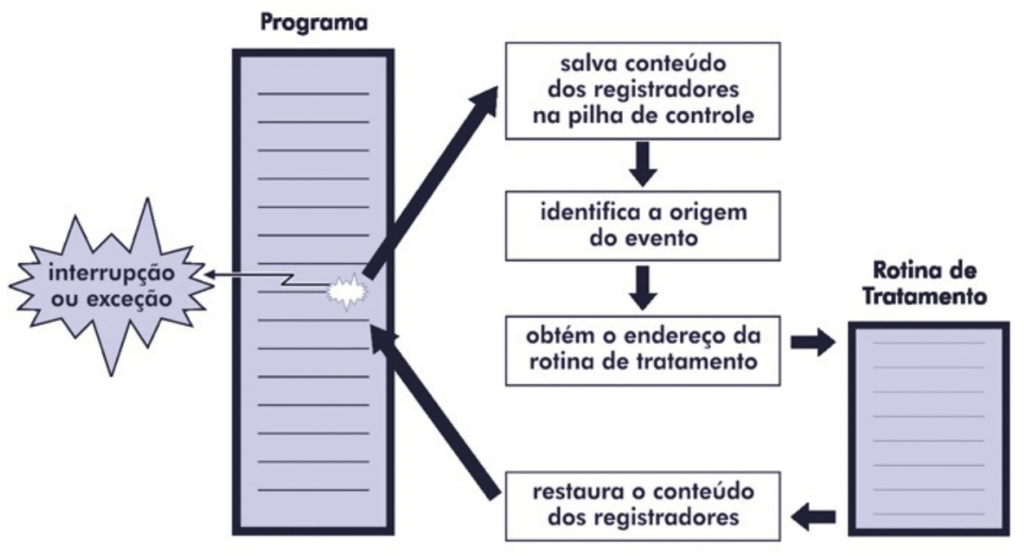
Fonte: Machado e Maia (2014, p. 63).
Otimização das operações de Entrada/Saída
O desempenho do sistema operacional e de todo o computador depende fortemente da eficiência das operações de E/S. Com o advento dos mecanismos de controle de fluxo, ao longo dos anos os SOs evoluíram para otimizar as operações de E/S, de forma a liberar a CPU para realizar outras tarefas e efetivamente permitir a concorrência.
Inicialmente, a comunicação entre a CPU e os periféricos era “controlada por um conjunto de instruções especiais, denominadas instruções de entrada/saída, executadas pelo próprio processador. Essas instruções continham detalhes específicos de cada periférico.” (Machado e Maia, 2014, p. 66). Esse modelo de funcionamento criava uma dependência muito forte entre o processador e os dispositivos de E/S.
Portanto, uma das primeiras modificações foi a simplificação das instruções de E/S por meio dos controladores (interfaces). Estas interfaces liberam o processador da necessidade de se comunicar detalhadamente com os periféricos, pois as especificidades ficam por conta da comunicação entre controlador e hardware, conforme pode-se verificar na Figura 3.
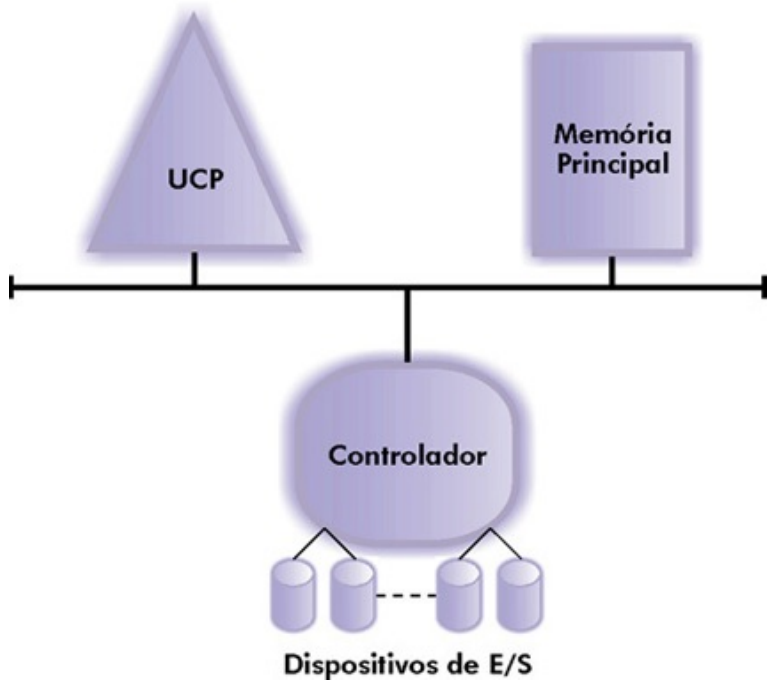
Fonte: Machado e Maia (2014, p. 66).
O próximo passo evolutivo era substituir a ineficiente comunicação controlada por programa (busy wait), na qual a CPU ficava testando periodicamente o estado do periférico. Com as interrupções, o controlador avisa o processador sobre o término da operação por meio de interrupções, liberando o processador para processar outras tarefas enquanto isso não acontece.
Segundo Machado e Maia (2014, p. 67), “a operação de E/S controlada por interrupção é muito mais eficiente que a controlada por programa, já que elimina a necessidade de o processador esperar pelo término da operação, além de permitir que várias operações de E/S sejam executadas simultaneamente.” Porém, com o tempo, o grande volume de dados transferidos exigia muitas intervenções do processador, o que reduzia sua eficiência. Para solucionar o problema, foi implementada uma técnica de transferência de dados denominada Direct Memory Access (DMA).
O DMA permite que a transferência de dados entre o controlador do dispositivo e a memória principal ocorra sem a intervenção do processador a todo momento, que fica livre para realizar outras tarefas novamente. Utilizando DMA, um bloco de dados pode ser transferido entre a memória principal e
dispositivos de E/S sem a intervenção do processador, exceto no início e no final da transferência. A Figura 4 apresenta uma imagem didática do diagrama de bloco de conexões dos componentes computacionais.
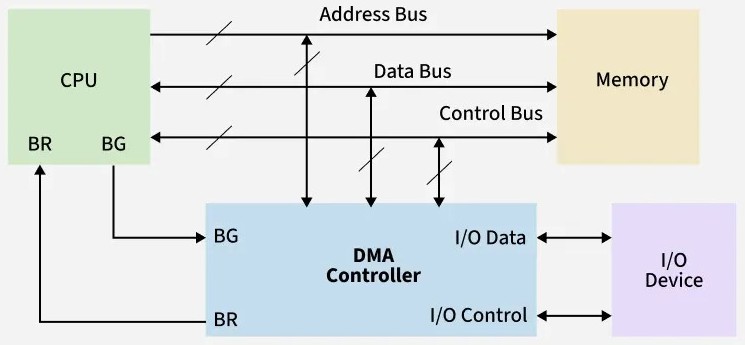
Fonte: Geeks for Geeks (2025).
A extensão do conceito do DMA possibilitou o surgimento do canal de entrada/saída. O conceito foi introduzido pela IBM no Sistema 7094 e basicamente é um processador com capacidade de executar programas de E/S, permitindo controle total sobre essas operações e mínima intervenção da CPU principal. Na Figura 5 pode-se observar como funciona o canal de E/S.
As instruções de E/S são armazenadas na memória principal pelo processador, porém o canal é responsável pela sua execução. Assim, o processador apenas realiza uma operação de E/S, instruindo o canal para executar um programa localizado na memória (programa de canal).
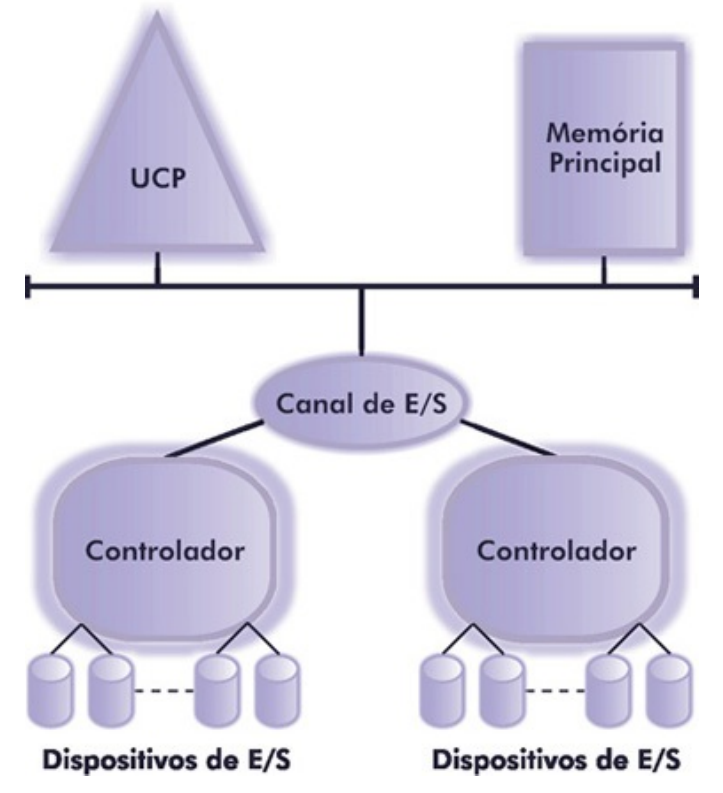
Fonte: Machado e Maia (2014, p. 68).
Aprimorando a concorrência por meio de técnicas de software
Do ponto de vista do software, três técnicas importantes de gerência de recursos são detalhadas por Machado e Maia (2014), dada a sua contribuição à concorrência. São elas o buffering, o spooling e a reentrância.
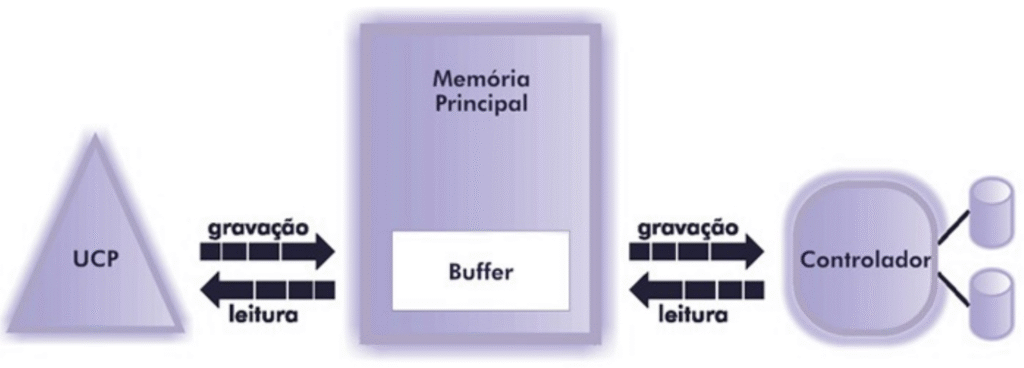
A técnica de buffering consiste no uso de uma área na memória principal, denominada de buffer, para
a transferência de dados entre os dispositivos de E/S e a memória, conforme pode-se verificar na Figura 6.
Ela permite que uma operação de leitura transfira o dado primeiramente para a área do buffer, liberando imediatamente o dispositivo de entrada para realizar uma nova leitura. Dessa forma, o buffering permite minimizar o problema da discrepância entre a velocidade do processador e dos dispositivos de E/S. Segundo Machado e Maia (2014, p. 68), “o objetivo principal desta técnica é manter, na maior parte do tempo, processador e dispositivos de E/S ocupados.”
Fonte: Machado e Maia (2014, p. 69).
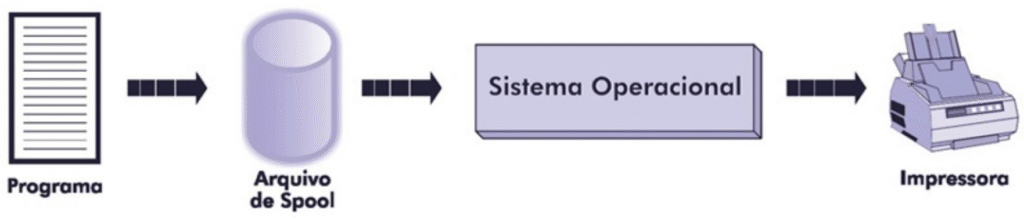
A segunda opção é o spooling, que é semelhante à técnica de buffering – armazenamento temporário de dados. Porém, a diferença é que no spooling utiliza-se uma área em disco como um grande buffer para o sistema computacional.
Criada em meados dos anos 50, essa técnica evoluiu das antigas fitas magnéticas para os modernos discos. Ela é amplamente utilizada no gerenciamento de impressão, onde as informações são gravadas em um arquivo de spool no disco, liberando imediatamente o programa para outras atividades. Isso desvincula o programa do dispositivo de impressão e garante um uso eficiente e organizado da impressora pelo sistema operacional. Na Figura 7 pode-se verificar que o arquivo de spool é acessado pelo sistema operacional para manipular dados de impressão
Fonte: Machado e Maia (2014, p. 70).
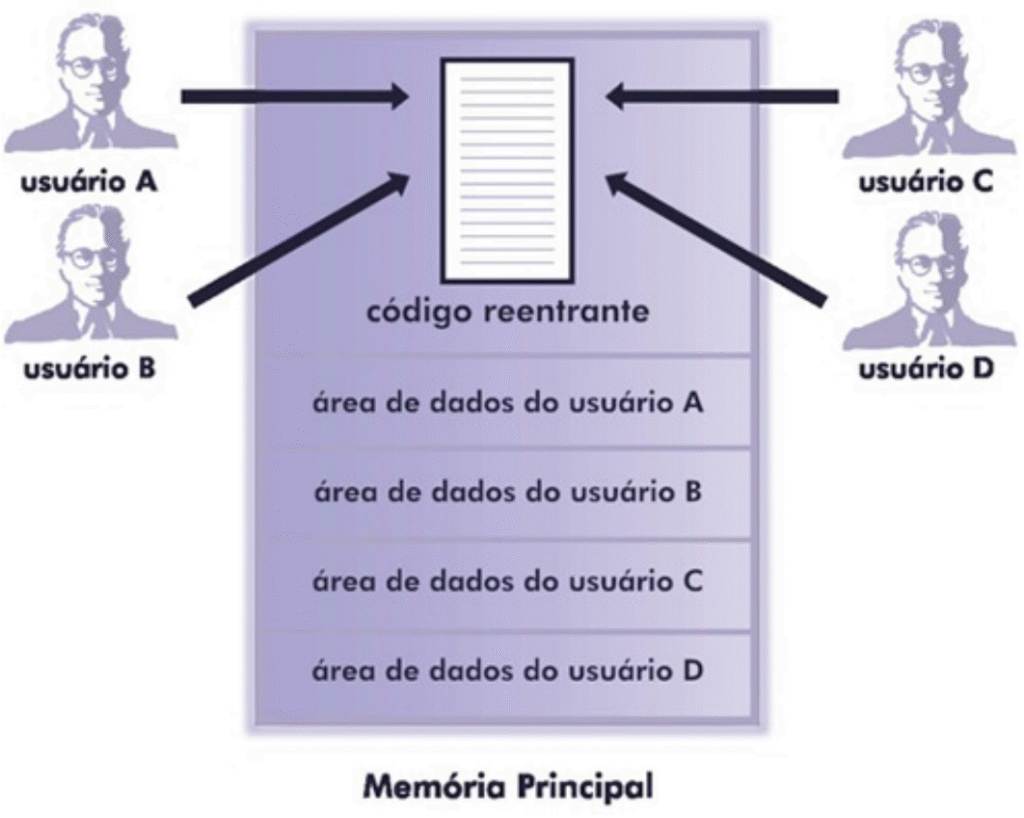
Por fim, a terceira técnica é chamada de reentrância e é a capacidade de um código executável ser compartilhado por diversos usuários simultaneamente, exigindo que apenas uma cópia do programa esteja residente na memória principal. Essa funcionalidade é crucial em sistemas multiprogramáveis para utilitários comuns, como editores de texto e compiladores, proporcionando uma utilização mais eficiente da memória.
Na Figura 8 é possível verificar que o código do programa construído de forma reentrante possui apenas uma cópia carregada na memória principal para todos os usuários do sistema. Entretanto, é importante destacar que a área de dados não é compartilhada entre os usuários, de forma que apenas as instruções de execução são partilhadas.
Fonte: Machado e Maia (2014, p. 71).
Considerações finais
A ideia da concorrência é muito importante para o funcionamento dos sistemas operacionais modernos, especialmente por conta de sua característica multitarefa e multiprocessadores. Com a evolução da tecnologia e o aumento da demanda por desempenho, a importância de técnicas eficientes de concorrência tende a crescer, tanto na indústria quanto na área acadêmica.
Aproveite o vídeo abaixo para complementar sua leitura. Bons estudos.
Referências
MACHADO, Francis Berenger; MAIA, Luiz Paulo. Arquitetura de sistemas operacionais. 5ª ed. Rio de Janeiro: LTC, 2014.
GEEKSFORGEEKS. Direct Memory Access (DMA) Controller in Computer Architecture. Última atualização: 23 jul. 2025. Disponível em: https://www.geeksforgeeks.org/computer-organization-architecture/direct-memory-access-dma-controller-in-computer-architecture/. Acesso em: 04 out. 2025.